
AI 風險評估與控制矩陣:elDoc 如何將 AI 治理落實於企業營運
AI 治理的一項根本挑戰,是如何由原則及政策進一步落實為真正可以部署、測試及驗證的控制機制。
企業可能已制定 AI 政策,要求保護機密資訊、審查 AI 輸出,並確保 AI 活動具備明確的問責機制。但治理層面更關鍵的問題是:
每項要求針對哪一項具體風險?哪項控制機制可以降低該風險?企業又如何證明相關控制機制確實有效運作?
這正是 elDoc AI 風險評估與控制矩陣 發揮作用的地方。
elDoc 採用縱深防禦模式,將 AI 風險對應至預防性、偵測性、修正性及治理控制機制。elDoc 並不將 LLM 視為可信的安全層,而是將控制機制貫穿身份、授權、文件、RAG、AI 處理、人工驗證、可稽核性及基礎設施等各個層面。
elDoc AI 風險評估與控制矩陣
| AI 風險範疇 | 主要風險 | 風險暴露 | elDoc 控制機制 | 控制類型 | 治理成效 |
|---|---|---|---|---|---|
| 身份與身份驗證 | 未獲授權人士取得 AI 功能的存取權 | 未經授權存取企業知識及 AI 操作 | MFA、SSO、身份驗證 | 預防性 | AI 功能始終受限於經身份驗證的企業存取範圍 |
| 授權 | 使用者透過 AI 存取超出其獲授權範圍的資訊 | 機密性遭到破壞 | RBAC、使用者/群組權限、文件層級存取控制 | 預防性 | 最小權限原則適用於使用者及 AI |
| AI 資料存取 | AI 檢索使用者通常無法存取的資訊 | 關鍵資訊洩露風險 | 存取感知 Agentic RAG | 預防性 | AI 繼承使用者獲授權的資訊範圍 |
| 上下文洩漏 | 未經授權的文件進入 LLM 上下文 | 敏感資訊可能出現在 AI 回應中 | 在檢索之前進行授權驗證 | 預防性 | 未經授權的資訊會在 LLM 處理之前被排除 |
| 提示注入 | 使用者嘗試透過提示詞繞過限制 | 未經授權的資訊檢索或操縱 | 不受提示詞影響、由應用程式強制執行的授權機制 | 預防性 | 提示詞指令無法自行擴大存取權限 |
| 間接提示注入 | 嵌入文件中的惡意指令操縱 AI | AI 行為或操作可能受到檢索內容影響 | 受控 RAG 上下文+權限強制執行+受控 AI 操作 | 預防性/治理 | 檢索內容無法自行授予額外權限 |
| 敏感資料洩露 | 機密企業資訊透過 AI 遭到洩露 | 資料洩露/機密性暴露 | 受控 LLM 介面+存取感知檢索 | 預防性 | LLM 對企業資訊的存取始終受到限制 |
| AI 資料主權 | 企業資訊在獲批准的基礎設施之外進行處理 | 監管、資料主權及機密性暴露 | on-premise/主權 AI 部署 | 預防性/治理 | AI 處理可維持於客戶控制的基礎設施內 |
| 外部 AI 依賴 | 外部 AI 供應商造成不可接受的資料暴露 | 第三方及資料主權風險 | 完全氣隙隔離的 AI 部署 | 預防性/治理 | LLM、RAG、嵌入向量及向量基礎設施可在不依賴外部 AI 服務的情況下運行 |
| 客戶資料與模型訓練 | 企業文件成為模型訓練的一部分 | 失去對企業資訊的控制 | 將客戶資料與底層 LLM 訓練分離 | 預防性/治理 | elDoc 不會使用企業文件訓練或微調底層 LLM |
| 幻覺 | AI 提供缺乏依據或不準確的答案 | 錯誤的業務決策 | RAG 溯源+來源參考+人工驗證 | 預防性/治理 | AI 回應可根據企業來源資訊進行驗證 |
| AI 輸出準確度 | GenAI 錯誤擷取文件中的數值 | 錯誤資料進入業務流程 | 欄位級資料評分+HITL 驗證 | 預防性/偵測性/治理 | 可識別及驗證低置信度結果 |
| 低置信度資料 | 不確定的 AI 結果自動進入後續流程 | 處理及決策錯誤 | 可配置的驗證門檻 | 預防性/治理 | 指定結果可轉交人工審查 |
| AI 自主操作權限過高 | AI 執行非預期的重大操作 | 營運或業務影響 | 受控 AI 操作+Human-in-the-Loop | 預防性/治理 | 重大操作仍由人工掌握權限 |
| AI 文件變更 | AI 錯誤分類、重新命名、重新整理或修改文件 | 文件完整性及營運風險 | 受監督的 AI 操作+HITL | 預防性/治理 | AI 建議的操作可經審查、修正、批准或拒絕 |
| AI 決策風險 | 錯誤的 AI 決策在工作流程中繼續推進 | 錯誤的後續業務操作 | GenAI 編排流程+HITL+Maker-Checker | 預防性/治理 | 可在後續工作流程階段之前進行驗證 |
| AI 問責 | 企業無法重建 AI 輔助活動 | 治理及調查方面的缺口 | 稽核日誌+與使用者關聯的活動記錄 | 偵測性/治理 | AI 輔助操作及批准記錄均可追溯 |
| 關鍵操作 | 敏感操作在未經獨立驗證的情況下發生 | 欺詐、錯誤或未經授權的操作 | 四眼原則 | 預防性/治理 | 關鍵操作可要求額外批准 |
| AI 輸出處理 | LLM 輸出觸發非預期的應用程式行為 | 安全/營運影響 | 受控輸出處理 | 預防性 | LLM 生成內容無法自行執行具特權的功能 |
| 向量/嵌入安全 | 向量基礎設施繞過文件權限 | 隱藏的授權缺口 | 授權感知檢索 | 預防性 | 向量搜尋不會成為獨立的授權機制 |
| 模型依賴 | 企業依賴不合適的模型/供應商 | 營運、成本、資料主權或安全依賴 | LLM 無關架構 | 治理/修正性 | 可根據企業要求替換模型 |
| AI 供應鏈 | 外部 AI 元件引入安全/依賴風險 | 第三方技術暴露 | 受控 AI 整合+可替換元件 | 預防性/治理 | 個別 AI 元件可受到控制、替換或升級 |
| AI 使用量 | 未受控制的 AI 使用量增加成本或降低服務效能 | 財務及營運風險 | 使用量追蹤+資源限制 | 預防性/偵測性 | AI 使用量可受到監控及限制 |
| AI 資源耗盡 | AI 工作負載影響應用程式效能 | 可用性風險 | 獨立的 AI 基礎設施容量規劃+並行控制 | 預防性/偵測性 | AI 容量可獨立於核心應用程式進行擴展 |
| 可用性與韌性 | 基礎設施故障中斷 AI 支援的流程 | 業務持續運作風險 | 高可用性及具韌性的部署架構 | 預防性/修正性 | AI 支援的操作可按照服務持續運作的要求進行設計 |
從風險評估到營運層面的 AI 治理
此矩陣突顯了紙面上的 AI 治理與融入企業營運的 AI 治理之間的重要區別。
政策可以界定 AI 應該或不應該執行的操作,但營運層面的 AI 治理更進一步,將每項已識別的風險與具體控制機制、執行機制、人工權限及可稽核證據建立關聯。
elDoc AI 治理鏈
AI 使用場景 → 風險 → 業務影響 → 控制機制 → 執行機制 → 人工監督 → 稽核證據
這建立了一條可追溯的治理鏈,從初始風險評估,一直延伸至用於管理相關風險的技術及組織控制機制。
| AI 風險 | elDoc 控制機制 | 如何執行控制 | 治理成效 |
|---|---|---|---|
| AI 洩露機密資訊 | 存取感知 Agentic RAG | 在檢索文件資訊並提供予 LLM 之前,先驗證使用者授權 | AI 無法自行擴大使用者獲授權的資訊範圍 |
| AI 錯誤擷取數值 | 欄位級資料評分+驗證門檻 | 可將指定結果轉交 Human-in-the-Loop 進行驗證,再進入後續流程 | 不確定的 AI 輸出不會自動成為可信的業務資料 |
| AI 執行錯誤的重大操作 | 受控 AI 操作+HITL+Maker-Checker | 可在指定工作流程階段引入人工授權及獨立驗證 | AI 可以協助執行操作,而重大決策仍由企業掌握最終權限 |
| AI 活動無法進行調查 | 稽核日誌+與使用者關聯的活動記錄 | 相關 AI 輔助操作、使用者活動及批准記錄均會納入適用的稽核框架 | 企業可維持對 AI 輔助操作的可追溯性及問責性 |
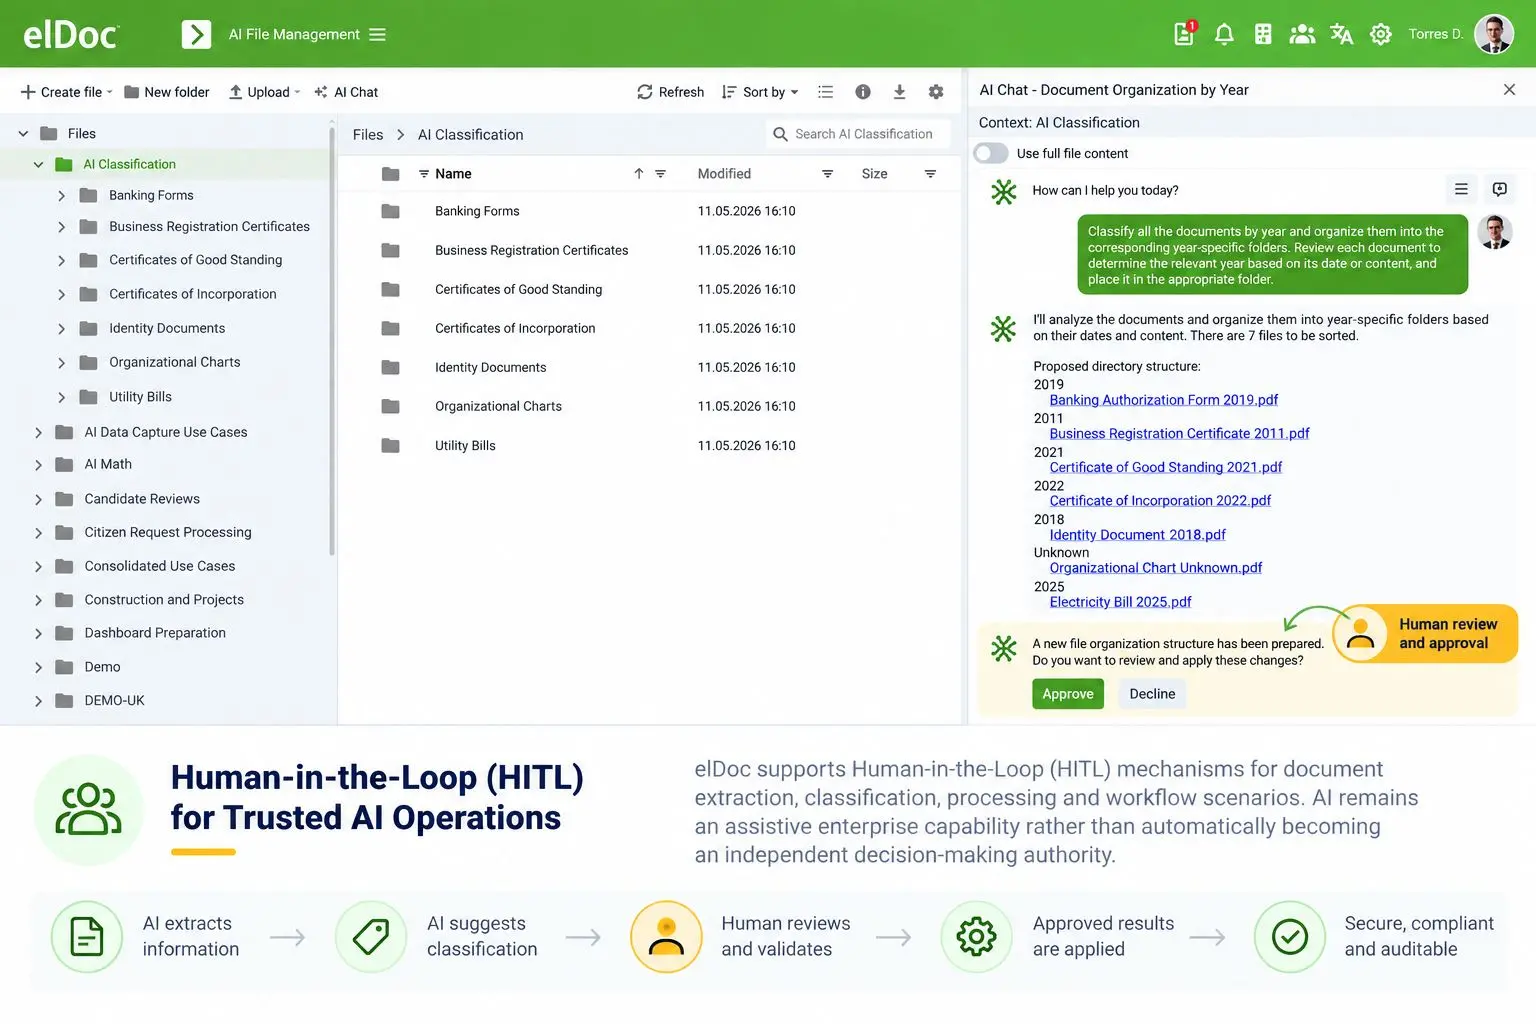
簡單示例:從風險到證據
以下以機密資訊透過 AI 回應遭到洩露的風險為例。
01:識別風險
AI 可能檢索出提出請求的使用者無權存取的資訊。
02:建立控制機制
elDoc 採用存取感知 Agentic RAG及現有的文件層級授權機制。
03:執行控制機制
在檢索企業資訊並將其作為上下文提供予 LLM 之前,先進行授權驗證。
04:維持人工及企業權限
LLM 不會成為獨立的授權層,亦無法自行為其本身或使用者授予額外的文件權限。
05:建立證據
適用的文件及系統稽核機制可追蹤相關的使用者及文件活動。
最終形成完整的治理關係:
識別風險 → 建立控制機制 → 執行控制機制 → 管理活動 → 維持證據
這正是 elDoc「設計即 AI 治理」方法的核心。
因此,AI 治理並不局限於界定可接受 AI 行為的政策,而是將技術強制執行、安全控制、人工監督、監控及可稽核性直接融入企業 AI 環境,形成完整的治理機制。
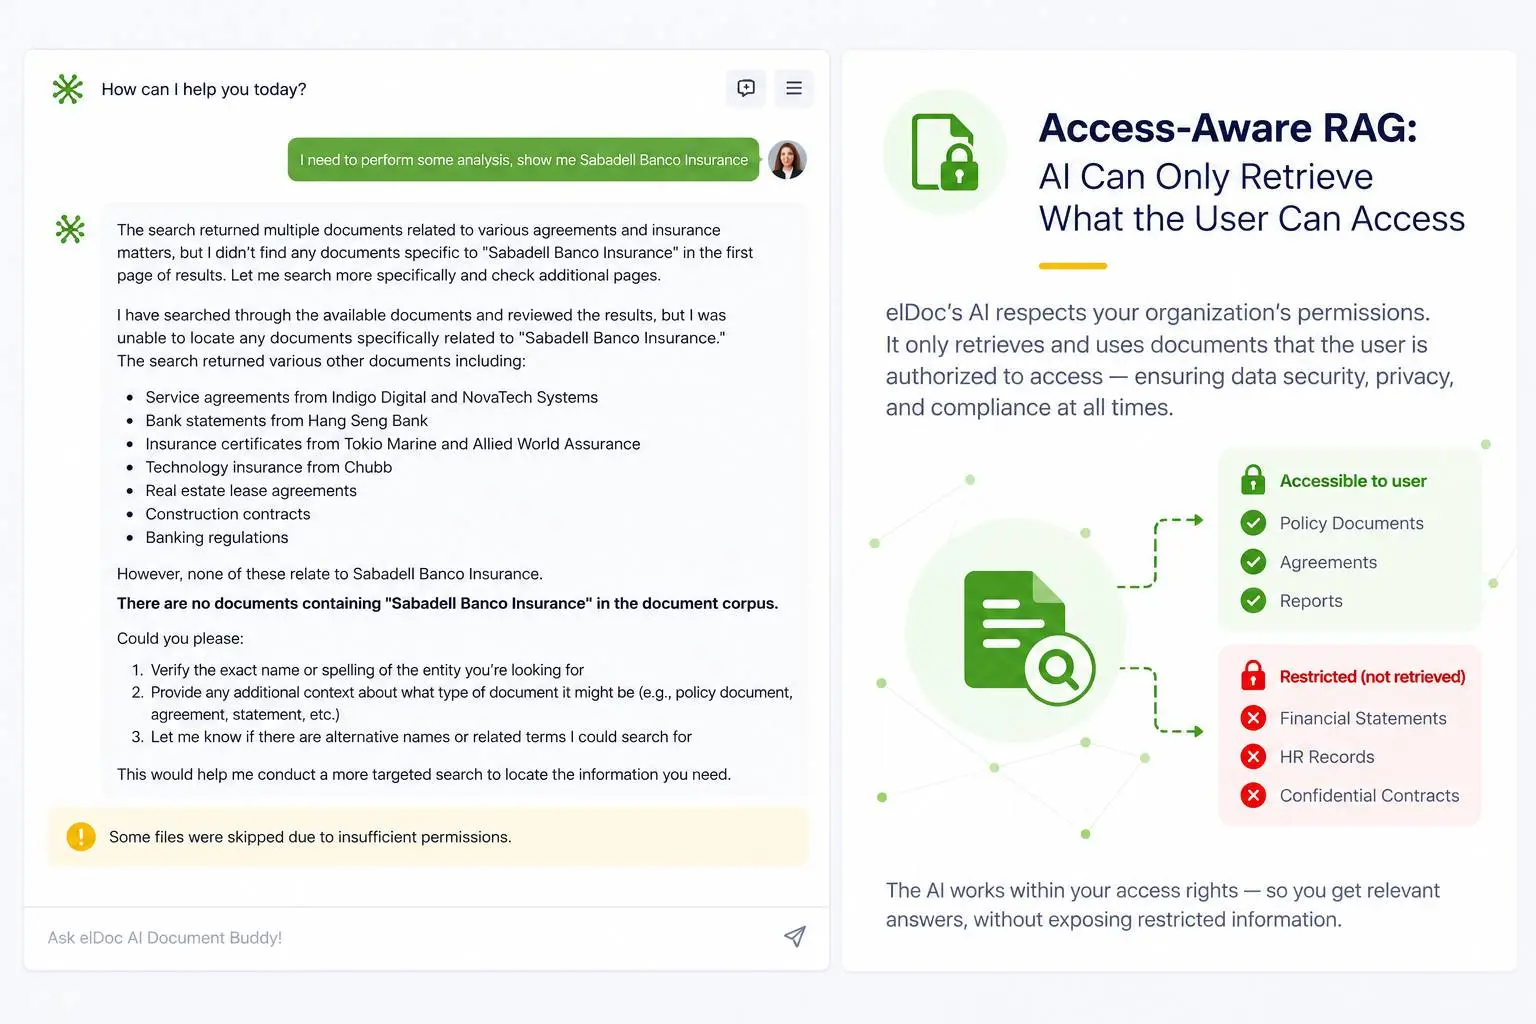
elDoc AI 治理控制的四個層面
因此,elDoc 的治理模式可透過以下四個互補的控制層面來理解:
| 控制層面 | 目的 | elDoc 示例 |
|---|---|---|
| 預防性 | 在未經授權或不安全的活動發生前加以阻止 | MFA、RBAC、存取感知 RAG、加密、受控 AI 操作、授權感知檢索 |
| 偵測性 | 識別、監控及重建活動記錄 | 稽核日誌、文件稽核軌跡、與使用者關聯的 AI 活動、資料評分、使用量監控 |
| 修正性 | 在條件發生變化時進行恢復、調整或替換 | 版本控制、具韌性的架構、可替換的 LLM/元件 |
| 治理 | 確保涉及重大影響的 AI 活動始終由企業掌握權限 | HITL、Maker-Checker、四眼原則、驗證門檻、主權 AI 政策 |
任何單一層面都不足以單獨提供完整保障。
預防 → 偵測 → 修正 → 治理
這種縱深防禦模式意味著,即使單一控制機制未能完全消除某項風險,其他控制機制仍可提供額外保障、提升可視性,並確保人工監督。
AI 治理必須具備可驗證性
對受監管機構而言,僅僅表示「我們的 AI 是安全的」並不足夠。
企業日益需要回答更具體的問題:
你們已識別哪些 AI 風險?
哪些控制機制可以應對這些風險?
這些控制機制在哪些層面執行?
誰有權覆核、批准或否決 AI 操作?
當 AI 的置信度不足時,會如何處理?
事後能否重建 AI 的操作過程?
能否證明未經授權的資訊從未成為 AI 上下文的一部分?
因此,elDoc 將 AI 治理視為營運層面的控制框架,而不僅是一套 AI 政策。
其目標是建立以下各項之間可追溯的關聯:
風險 → 控制機制 → 執行機制 → 人工監督 → 證據
正是這種關聯,讓 AI 治理從政策及文件層面的要求,轉化為企業實際可執行的治理能力。
透過 elDoc 實現「設計即 AI 治理」
AI 治理不應在 AI 解決方案部署完成後才加入。
而應從架構設計之初便將其納入其中。
elDoc 將企業文件安全、存取感知 Agentic RAG、受控 LLM 介面、Human-in-the-Loop 驗證、Maker-Checker 控制機制、AI 資料評分、可稽核性、主權部署及受控 AI 操作整合於同一治理架構之中。
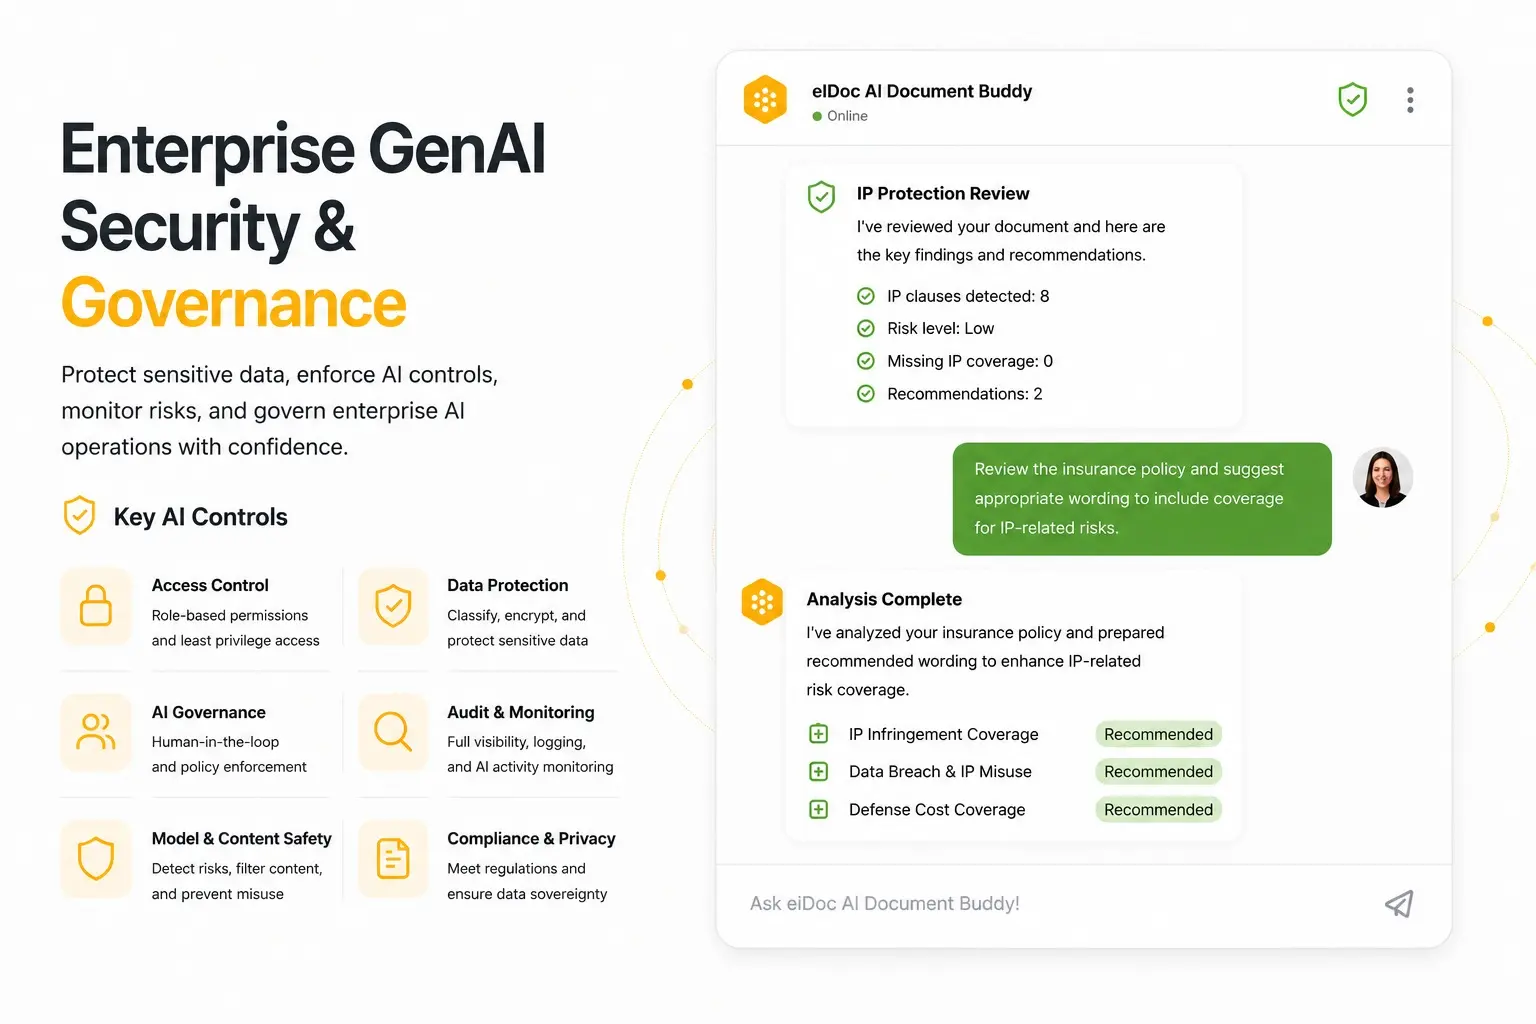
這讓企業不再只需思考:
「我們能否使用 GenAI?」
而可以進一步思考更重要的企業層面問題:
「我們能否證明 GenAI 的運作始終符合既定的風險範圍、權限、控制機制、人工權限及可稽核性要求?」
這正是「設計即 AI 治理」的基礎。