
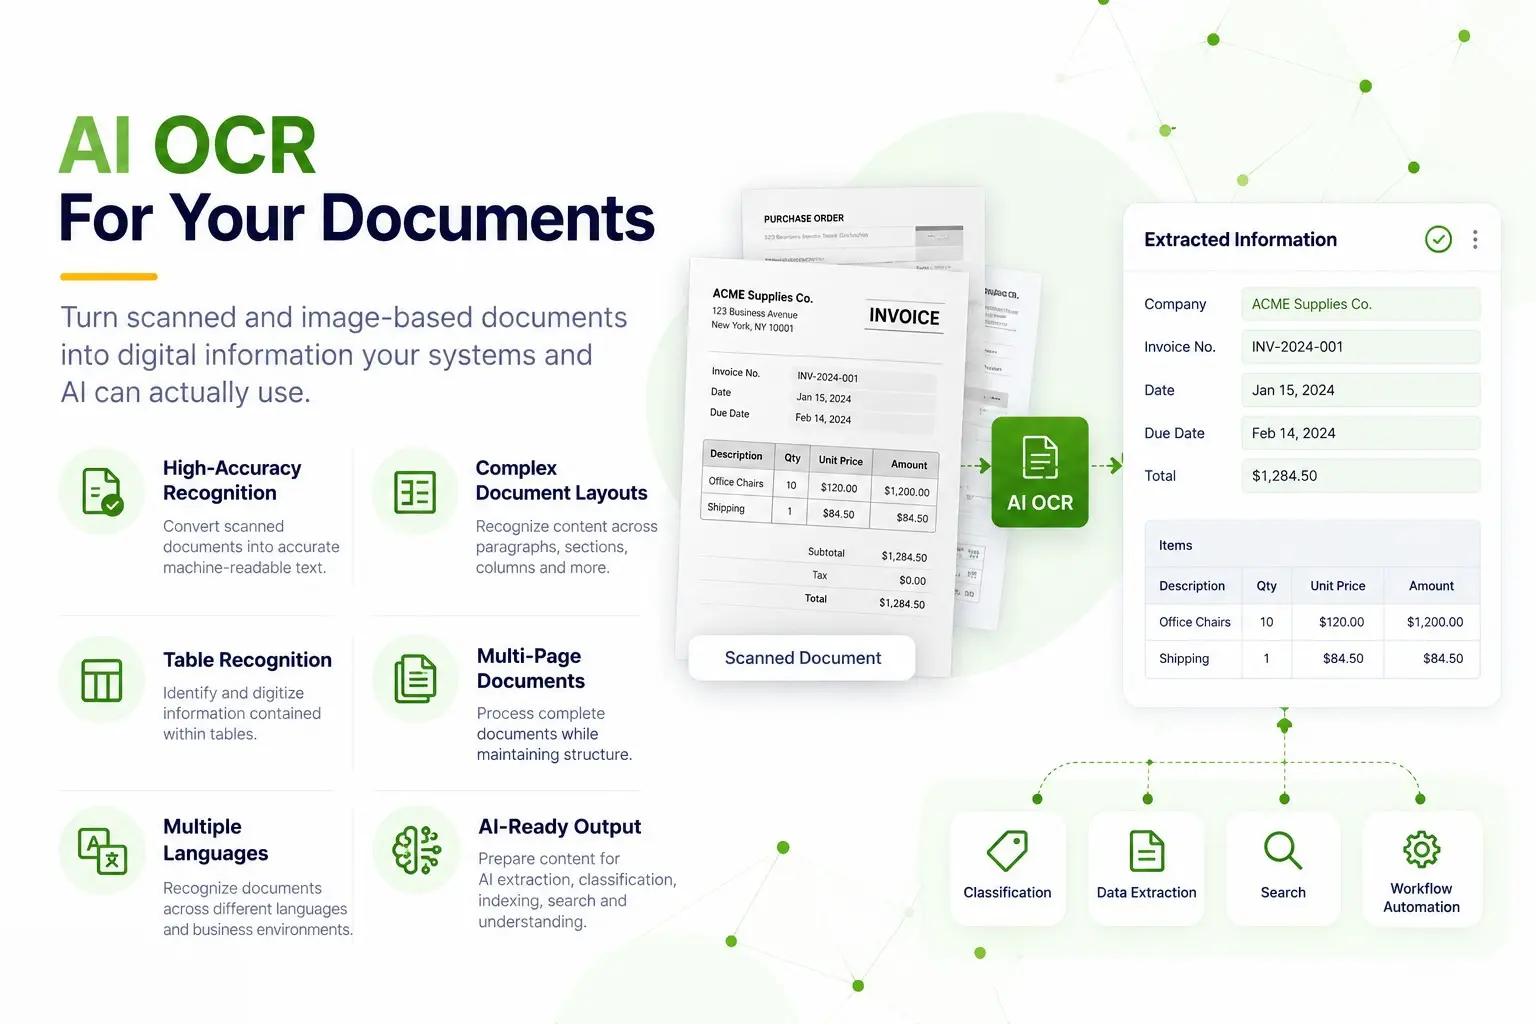
文件上傳時即時進行 AI OCR
文件進入 elDoc,即刻做好 AI 處理準備
elDoc 在文件上傳及匯入時自動執行 OCR,將掃描文件及圖片轉化為可機讀、可搜尋且可直接供 AI 處理的內容
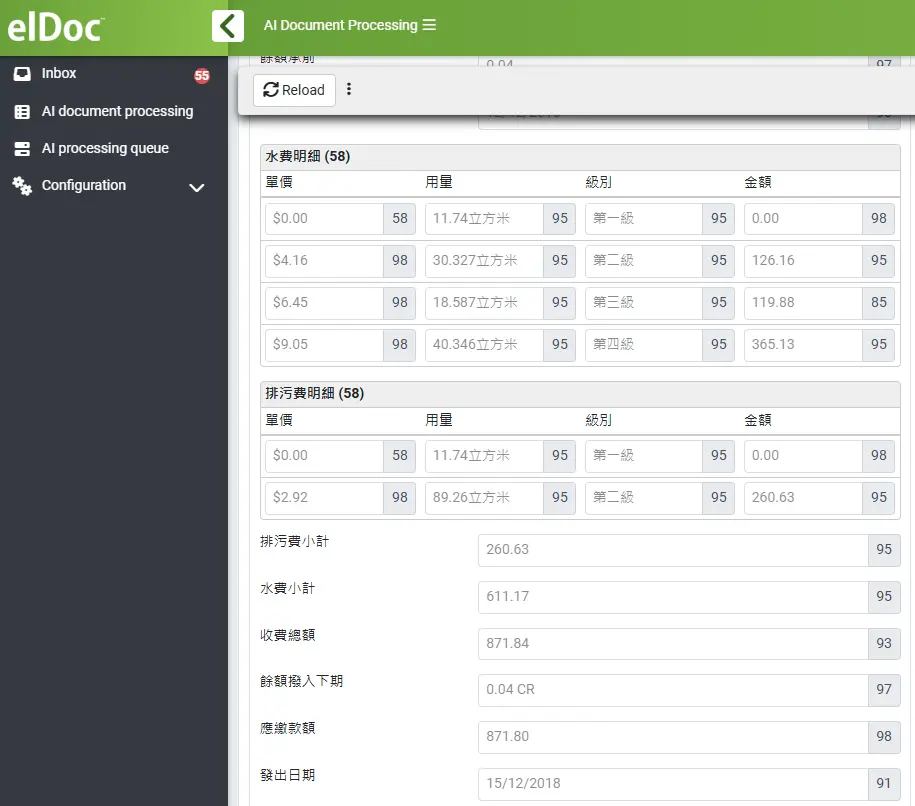
從 OCR 到 AI,即時就緒
OCR 輸出即時可供 AI 處理
文件在上傳時自動完成 OCR 處理,識別後的內容可立即用於 AI 分析、資料擷取、分類、搜尋及自動化
AI OCR 常見問題解答
了解 elDoc AI OCR 的常見問題,涵蓋文件識別、語言支援、準確度及部署方式
1. 什麼是 AI OCR?如何運作?
AI OCR 將掃描文件、PDF 及圖片中的文字與資訊轉化為可機讀內容。在 elDoc 中,OCR 是進一步進行 AI 處理的基礎,支援資料擷取、分類、分析、搜尋及自動化
2. elDoc AI OCR 支援哪些文件類型及檔案格式?
elDoc 可處理多種商業文件,包括發票、表格、合約、申請文件、證書、結單、報告及往來文件。文件可採用 PDF、掃描檔、相片、TIFF、PNG、JPEG 及其他支援的格式
3. 支援哪些語言及文字系統?
elDoc AI OCR 可支援超過 180 種語言,實際支援範圍取決於所選 OCR 引擎及配置。支援的主要文字系統包括拉丁、西里爾、阿拉伯、中文、日文、韓文、希臘文、希伯來文等。企業可根據語言、文件類型、準確度及部署需求選擇不同 OCR 引擎,在單一 elDoc 環境中實現多語言文件處理
4. elDoc 支援哪些 OCR 引擎?
elDoc 支援多種文件識別技術,包括 Google Cloud Vision OCR、PaddleOCR、Tesseract OCR 及視覺語言模型(VLM),可根據文件類型、語言、複雜程度、準確度、安全性及基礎架構需求,靈活選擇合適的方案。處理環境可由雲端服務配置至完整 On-Premise 部署,協助企業滿足效能、資料駐留及安全性要求
5. 如果掃描文件或圖片歪斜或品質欠佳,怎麼辦?
elDoc 結合 OCR 與電腦視覺技術,在文字及資料識別前先對文件進行預處理。系統可自動標準化圖片,修正歪斜、方向錯誤、變形及影像品質不一致等問題,提升 OCR 識別效果。
這讓 elDoc 能夠處理更廣泛的實際文件,包括掃描文件、拍攝的文件及品質不理想的圖片。不過,識別準確度始終取決於原始文件的品質及可讀性
6. elDoc 如何運用識別信心分數?
elDoc 可為每個識別或擷取的欄位提供信心分數,反映所擷取資料的可信程度。
系統可根據信心分數,自動將信心度較低的結果交由人工覆核及驗證,而信心度較高的資料則可無需人工介入,直接進入後續工作流程。這種 Human-in-the-Loop 處理模式讓人工資源集中於真正需要關注的內容
7. 文件上傳時可以自動執行 OCR 嗎?
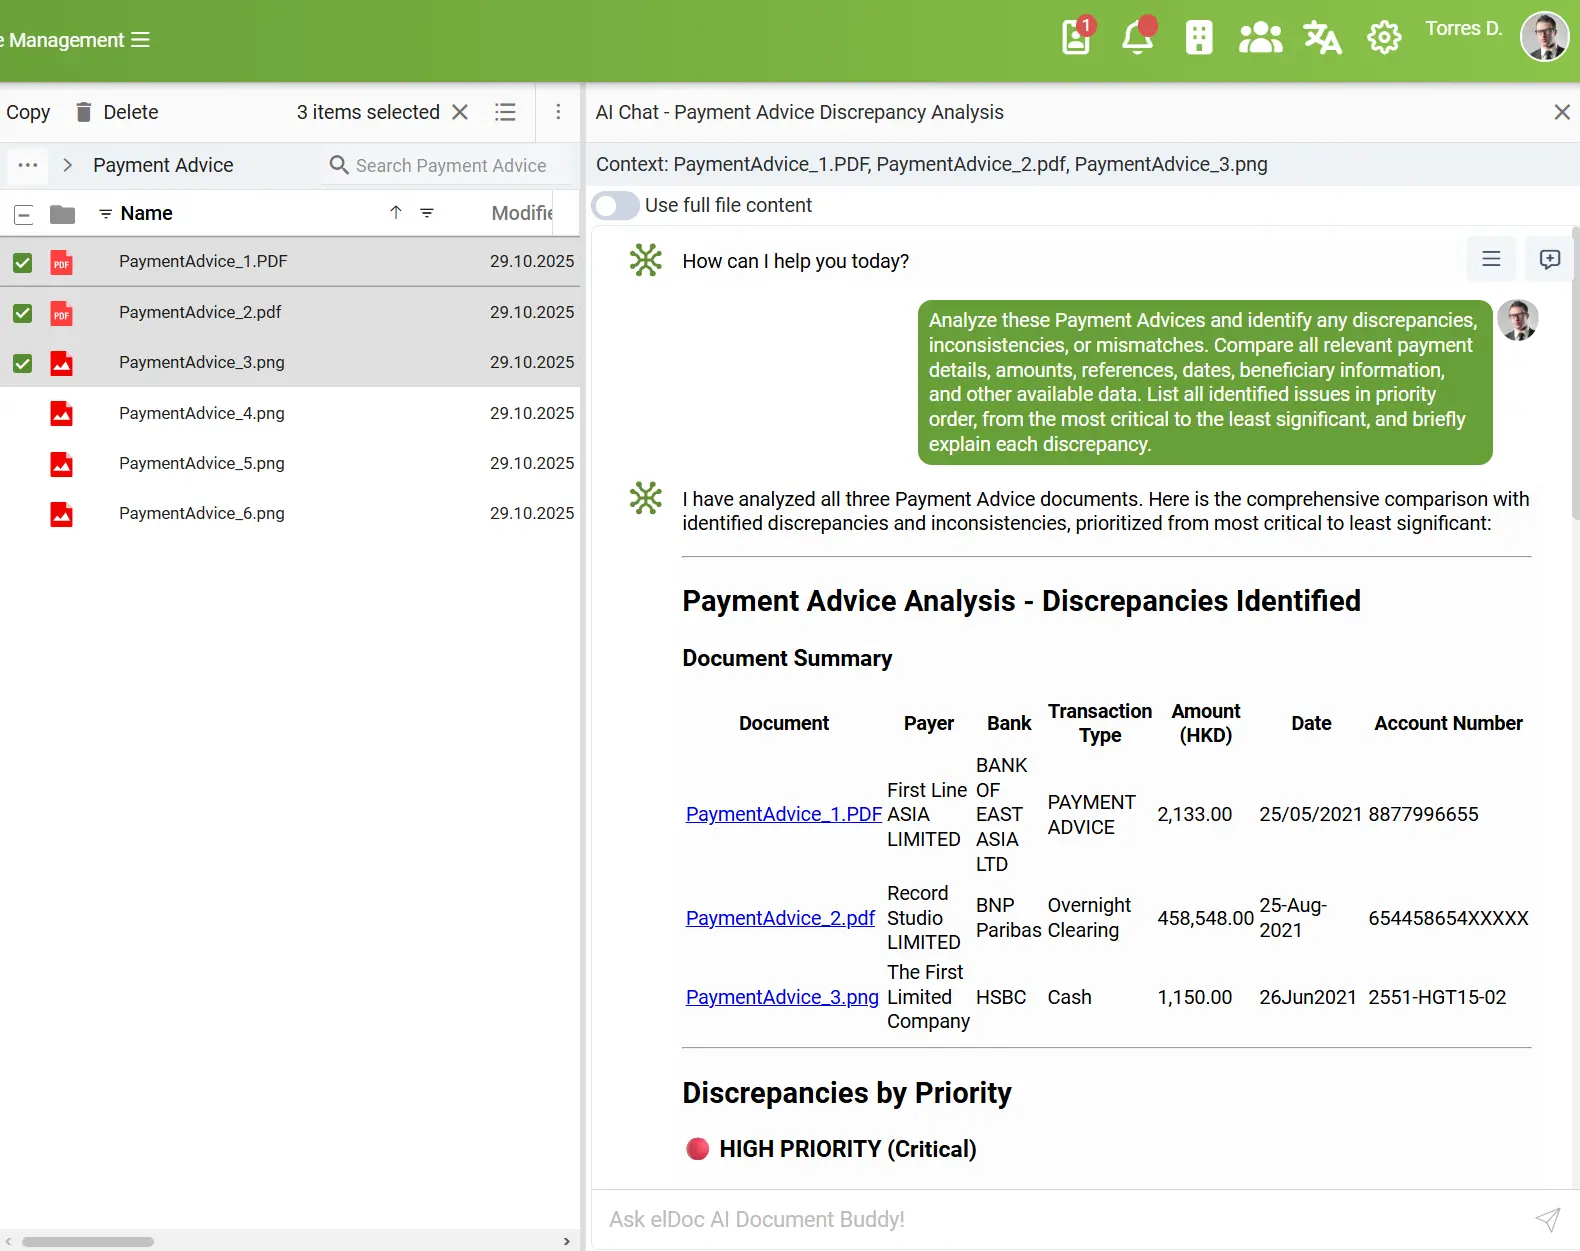
可以。OCR 會在文件上傳及匯入時自動執行,無需額外的處理步驟。完成後,識別內容即可立即供 elDoc 中的 AI 處理、Agentic RAG、智能資料擷取及 AI Document Agents 使用
8. elDoc AI OCR 可部署於 On-Premise 或氣隙隔離環境嗎?
可以。elDoc 支援多種 OCR 引擎及部署模式,從雲端服務到完整 On-Premise 處理均可。適當的 On-Premise 配置可支援文件必須留在受控基礎架構內,且外部連線受到限制的環境

親身了解 elDoc AI OCR 的實際應用
探索 elDoc AI OCR 如何處理您的文件
預約示範並帶上您的文件範例,親身了解 elDoc 如何在實際情境中識別及處理不同文件、語言及版面
聯絡我們
想仔細看看嗎?給我們留言以安排您的演示
回答您的問題或安排演示以了解我們的解決方案的實際應用:只需給我們留言