
Mejora la precisión de la captura de datos de documentos con IA, AI Prompts y configuración de LLM

Extraer datos de los documentos ya no es la parte más compleja de la automatización documental.
La IA moderna puede reconocer facturas, contratos, órdenes de compra, extractos bancarios, documentos de identidad, formularios, correspondencia y muchos otros tipos de documentos con una precisión notable. Sin embargo, extraer un valor no equivale a generar datos fiables y preparados para su uso empresarial.
Un modelo puede leer correctamente 12,500.00 en un documento y, aun así, no ser capaz de determinar si se trata de un subtotal, un importe de impuestos, el total de una factura, un límite de crédito o algo completamente distinto.
Aquí es donde la configuración de la IA generativa adquiere especial relevancia.
Con plataformas como elDoc, las organizaciones pueden ir más allá del OCR tradicional y configurar la IA en función del significado de los documentos y los datos. Esto incluye:
- AI Prompts a nivel de tipo de documento
- AI Prompts a nivel de campo individual
- selección del LLM adecuado para cada tipo de documento
- configuración de la temperatura del LLM en función de la tarea
- validación y comprobación cruzada de la información extraída
- reglas de negocio y controles deterministas sobre los resultados generados por la IA
- validación Human-in-the-Loop cuando sea necesaria
El objetivo no es simplemente extraer más datos. Es generar datos empresariales más precisos, coherentes, validados y utilizables.
Empiece por el tipo de documento y la clasificación documental mediante IA
Cada tipo de documento requiere un comportamiento diferente de la IA.
Una factura no se procesa de la misma manera que un contrato. Un extracto bancario es diferente de un documento de identidad y, del mismo modo, incluso documentos que parecen prácticamente idénticos pueden requerir una clasificación distinta en función de su contenido, contexto empresarial o identificadores específicos.
Por este motivo, la configuración de la IA debe comenzar a nivel de tipo de documento.
Con la IA generativa, la clasificación documental no tiene por qué basarse únicamente en el diseño del documento, las palabras clave o las plantillas predefinidas. Un prompt de IA puede definir una lógica de negocio específica para determinar cómo deben reconocerse y clasificarse los documentos.
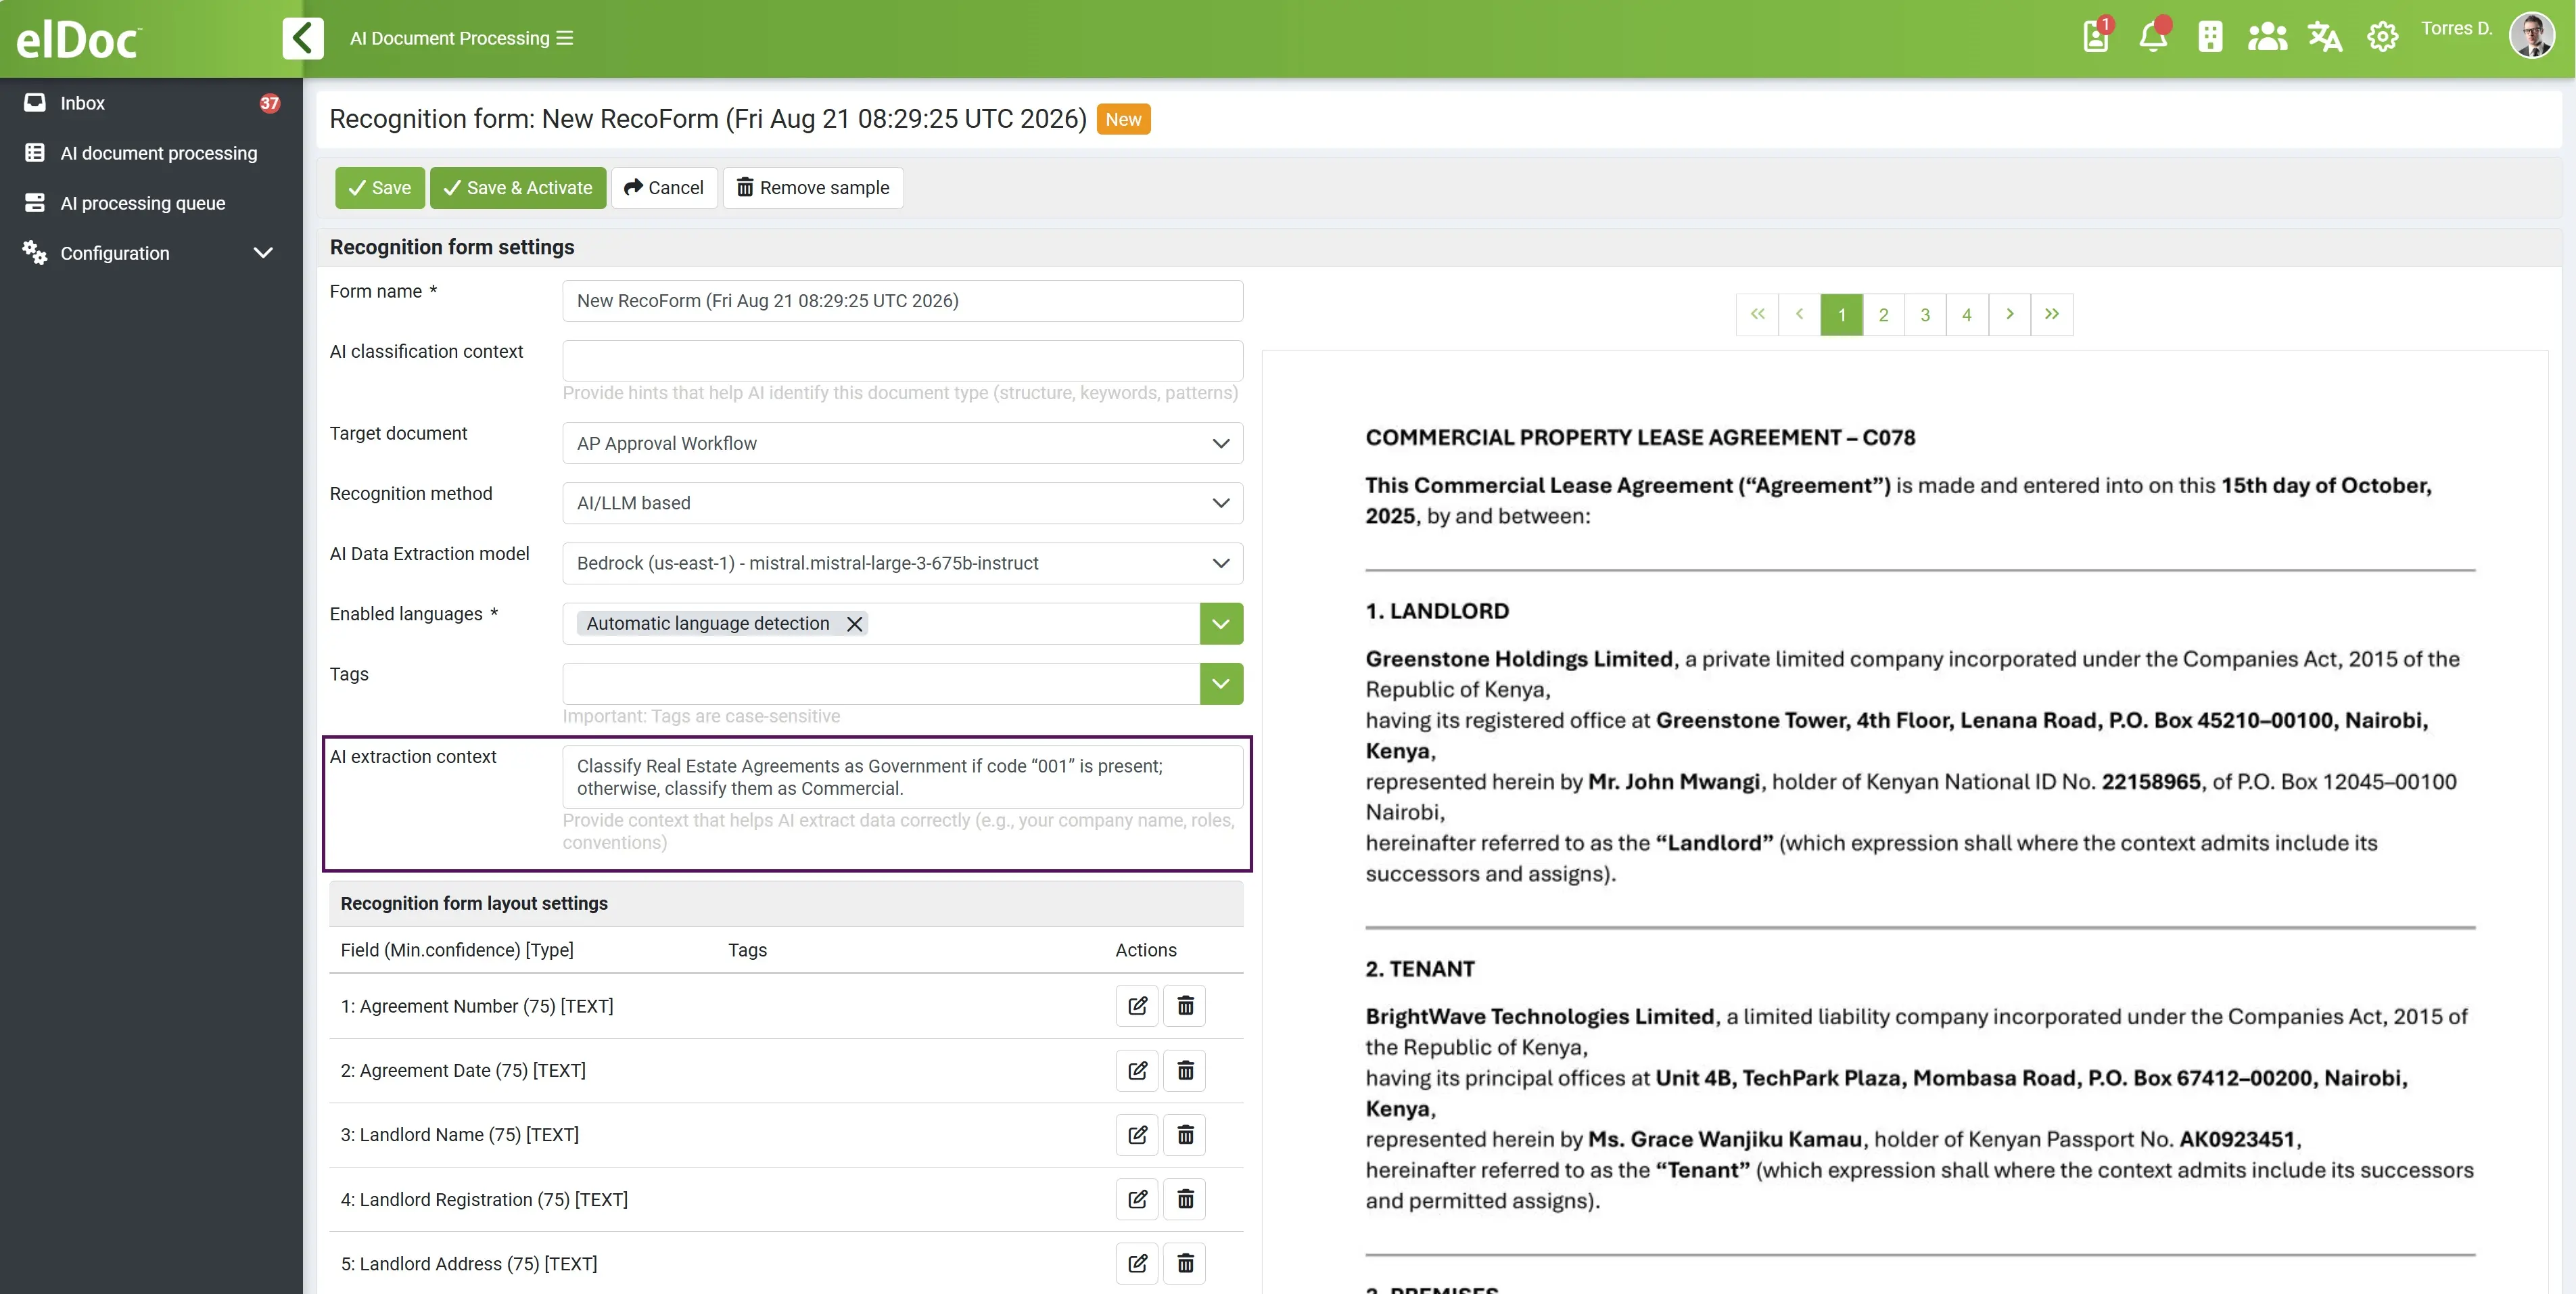
Por ejemplo, una organización puede gestionar varias categorías de acuerdos con estructuras muy similares. En lugar de intentar distinguirlos visualmente, el prompt de clasificación puede indicar a la IA que analice un código contractual específico:
Analiza el documento e identifica el código contractual. Si está presente el código 003, clasifica el documento como Commercial Agreement. Si está presente el código 002, clasifica el documento como Government Agreement. Si está presente el código 001, clasifica el documento como Framework Agreement. No determines el tipo de documento basándote únicamente en su título o diseño visual. Si no es posible identificar de forma fiable ninguno de los códigos especificados, clasifica el documento como Agreement general.
La lógica de clasificación puede ser considerablemente más sofisticada. Por ejemplo, la IA puede analizar simultáneamente varios elementos de información:
Clasifica el documento como Government Agreement cuando se identifique el código 002 o cuando la contraparte contractual sea una autoridad gubernamental y el documento contenga una referencia a una contratación pública. Si existen indicadores contradictorios, no hagas suposiciones y clasifica el documento como Agreement general.
Esta es una diferencia importante entre la clasificación documental convencional y la clasificación documental basada en IA.
La clasificación tradicional suele plantearse la siguiente pregunta:
«¿A qué tipo de documento se parece?»
En cambio, se puede indicar a la IA generativa que determine:
«¿Qué tipo de documento es según nuestras reglas de negocio y la información que contiene?»
Por tanto, los prompts de clasificación pueden incorporar códigos de documentos, identificadores, contrapartes, terminología, cláusulas contractuales, importes, fechas, contexto empresarial o combinaciones de múltiples condiciones.
La clasificación documental se convierte así en la primera capa de calidad de los datos: comprender correctamente qué es el documento antes de determinar qué información debe extraerse de él.
Utilice AI Prompts para validar, no solo para extraer
Una de las aplicaciones más valiosas de la IA generativa es utilizarla para validar la información extraída.
Por ejemplo, una vez extraídos los importes de una factura, se puede indicar a la IA que compruebe si:
Subtotal + Impuestos − Descuentos = Importe total
También puede comparar información relacionada que aparezca en otras partes del documento.
Por ejemplo, un prompt de campo podría indicar:
Extrae el importe total de la factura y verifícalo con respecto al subtotal, los impuestos aplicables, los descuentos y otros ajustes indicados en la factura. Si el importe calculado no coincide con el total indicado, devuelve un valor de 0 para su validación.
Una lógica similar puede aplicarse a numerosos procesos documentales:
| Documento | Ejemplo de validación mediante IA |
|---|---|
| Factura | Validar subtotal, impuestos e importe total |
| Orden de compra | Comparar los totales de las partidas con el total de la orden de compra |
| Contrato | Comparar las fechas indicadas con los periodos contractuales |
| Extracto bancario | Conciliar el saldo inicial, las transacciones y el saldo final |
| Documento KYC | Comparar nombres, fechas e identificadores entre documentos |
| Formulario de solicitud | Identificar información ausente o contradictoria |
| Reclamación de seguro | Comparar los importes reclamados con la información proporcionada en los documentos justificativos |
Esto establece una distinción importante entre la extracción mediante IA y la calidad de datos asistida por IA.
Configure la IA para gestionar información ausente o ambigua
Una de las principales causas de una baja calidad de los datos no es un OCR incorrecto, sino las suposiciones erróneas o, sencillamente, la ausencia de información crítica en el documento.
Si la IA no encuentra un valor, un modelo sin restricciones puede intentar inferirlo a partir de la información circundante. Esto puede resultar útil en determinados escenarios, pero ser inaceptable en otros. Para los campos críticos para el negocio, a menudo es preferible no devolver ningún valor antes que introducir en el sistema información que el documento no permite respaldar de forma fiable.
Este comportamiento puede configurarse mediante los ajustes de cada campo. Por ejemplo:
Extrae el ID fiscal del cliente exactamente como aparece en el documento. No infieras, generes ni deduzcas el valor a partir de otra información. Si el ID fiscal del cliente no está presente o no puede identificarse de forma fiable, no devuelvas ningún valor.
Sin embargo, en algunos casos, devolver un valor vacío es solo el comienzo del proceso.
Si un campo determinado es obligatorio para el proceso de negocio, puede configurarse como tal. Cuando la IA no devuelve ningún valor para un campo obligatorio, el sistema puede activar automáticamente un flujo de validación o gestión de excepciones, en lugar de permitir que el documento continúe mediante Straight-Through Processing.
Por ejemplo, es posible que un ID fiscal del cliente obligatorio simplemente no figure en ninguna parte del documento recibido. La IA no puede extraer información que no está presente. En este caso, el documento puede derivarse automáticamente a un usuario para su revisión.
Esto establece una distinción importante:
La extracción mediante IA determina qué información puede obtenerse de forma fiable del documento. La validación empresarial determina si esa información es suficiente para continuar el proceso.
El mismo enfoque puede aplicarse a la información ambigua. Por ejemplo:
Si aparecen varios números de cuenta bancaria, selecciona la cuenta identificada explícitamente para realizar el pago. Si no es posible determinar de forma fiable qué cuenta debe utilizarse, no selecciones ninguna de forma arbitraria. No devuelvas ningún valor.
Con este enfoque, la información ausente o ambigua no se convierte silenciosamente en datos empresariales de baja calidad. En su lugar, se transforma en una excepción controlada que puede activar automáticamente el proceso de validación correspondiente y una revisión Human-in-the-Loop.
Por tanto, una configuración adecuada de la IA define no solo qué debe extraer la IA, sino también qué no debe asumir y qué debe suceder cuando la información requerida no puede obtenerse de forma fiable del documento.
Seleccione el LLM adecuado para cada tipo de documento
Existe otra decisión de configuración importante: ¿qué modelo debe procesar el documento?
No todos los documentos requieren el mismo LLM.
Los distintos modelos pueden ofrecer capacidades diferentes en aspectos como razonamiento, comprensión visual de documentos, procesamiento multilingüe, velocidad, tamaño de la ventana de contexto, arquitectura de implementación, residencia de datos y coste.
Con una arquitectura agnóstica respecto a los LLM, las organizaciones no tienen por qué elegir un único modelo para todos los escenarios de procesamiento documental.
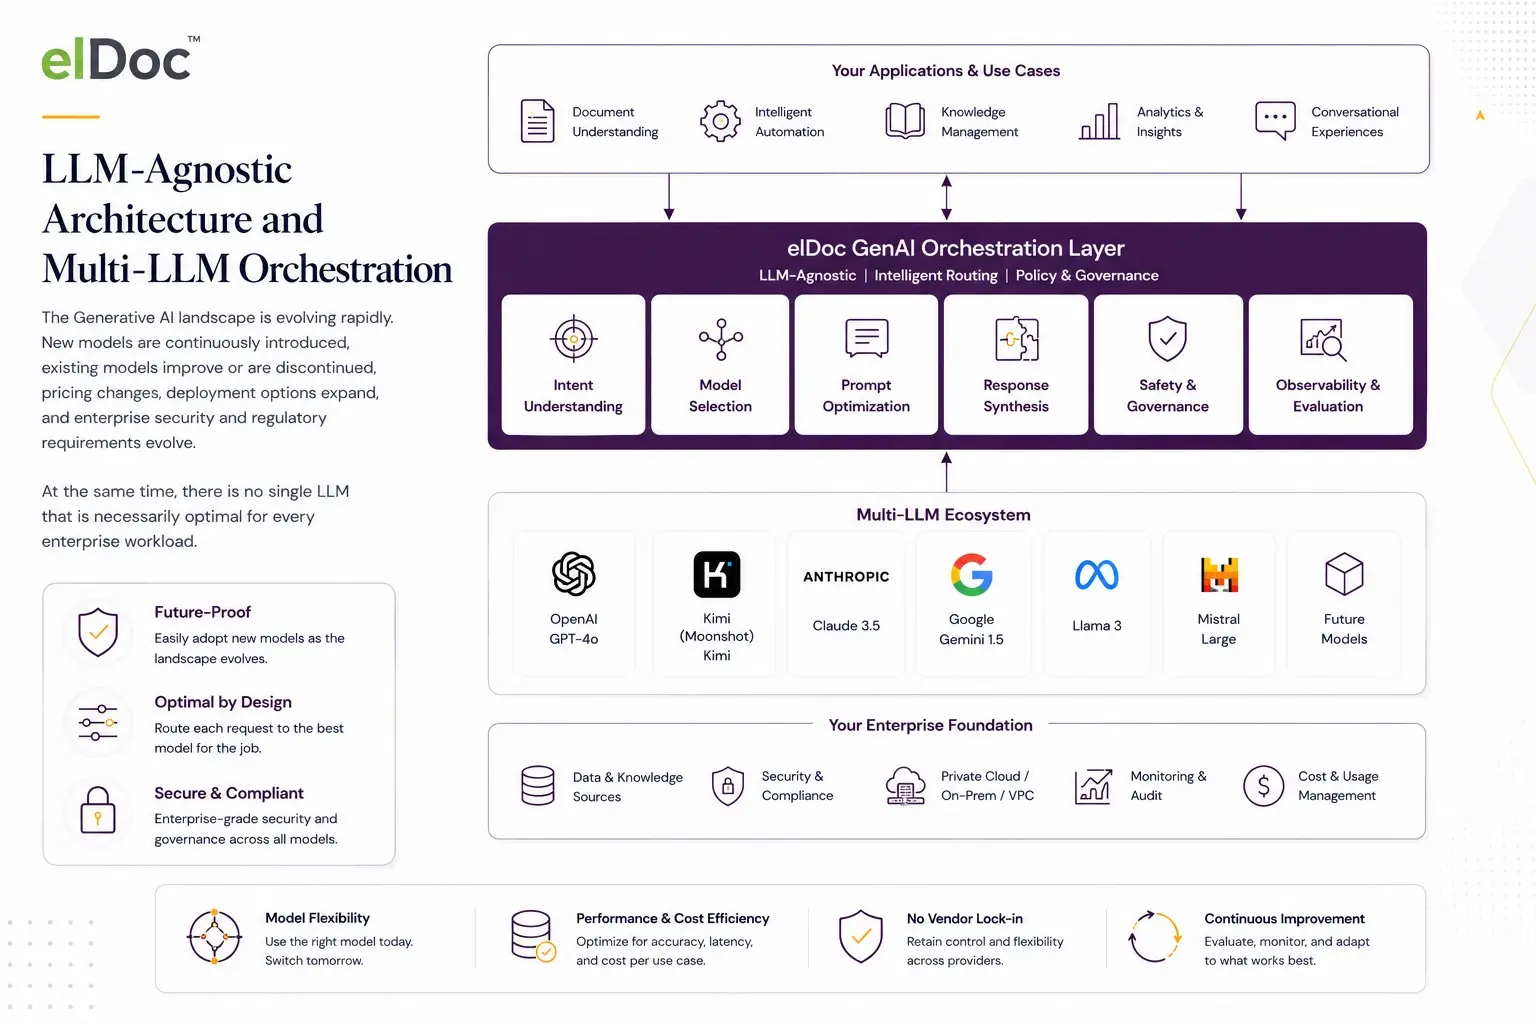
En su lugar, la selección del modelo puede adaptarse al tipo de documento y a los requisitos de negocio.
| Tipo de documento | Requisitos del modelo |
| Facturas estándar | Extracción rápida, precisa y eficiente en costes |
| Contratos complejos | Capacidades avanzadas de razonamiento y una amplia ventana de contexto |
| Formularios escaneados | Sólida comprensión visual y documental |
| Documentos multilingües | Sólidas capacidades multilingües |
| Documentos KYC | Alta precisión, comprensión visual y procesamiento controlado |
| Correspondencia | Sólida comprensión semántica y capacidad de clasificación |
| Informes financieros extensos | Amplia ventana de contexto y capacidad de razonamiento analítico |
Por ejemplo, una empresa que procese cientos de miles de facturas relativamente estandarizadas puede priorizar la velocidad, la precisión y el coste de procesamiento.
Para acuerdos jurídicos complejos, la organización puede optar por un modelo con mayores capacidades de razonamiento, aunque el procesamiento de cada solicitud sea más lento.
Por tanto, la selección del modelo se convierte en otro instrumento para mejorar tanto la calidad de los datos como la eficiencia del procesamiento.
Configure la temperatura del LLM según la tarea
Una vez seleccionado el LLM, otro parámetro que puede influir en su comportamiento es la temperatura.
En términos sencillos, la temperatura controla el grado de aleatoriedad con el que el modelo selecciona el siguiente token al generar una respuesta. El modelo calcula una distribución de probabilidad sobre los posibles tokens siguientes; la temperatura modifica esa distribución antes de seleccionar uno.
Con una temperatura más baja, la distribución de probabilidad se vuelve más concentrada. El modelo tiene mayor probabilidad de seleccionar las opciones con mayor probabilidad, lo que generalmente hace que sus resultados sean más coherentes, predecibles y reproducibles.
Con una temperatura más alta, la distribución de probabilidad se vuelve más uniforme. Aumenta la probabilidad de seleccionar tokens alternativos, lo que incrementa la variación y diversidad de la respuesta generada.
Una forma práctica de entenderlo es:
Temperatura más baja → priorizar la coherencia y la precisión.
Temperatura más alta → permitir una mayor variación y exploración.
La temperatura no equivale directamente a precisión ni inteligencia. Establecer la temperatura en 0 no garantiza que una respuesta sea correcta, y aumentarla no hace que el modelo razone mejor. Su función principal es modificar la variabilidad de la generación.
¿Qué temperatura debe utilizarse para el procesamiento documental?
En la mayoría de las tareas de procesamiento documental empresarial, el comportamiento deseado es muy diferente del que se busca en la generación de contenido creativo.
Al extraer un número de factura, un importe de IVA, el nombre de un cliente, la fecha de un contrato, un IBAN, un número de orden de compra u otra información estructurada, normalmente existe una única respuesta correcta.
Si el número de factura es INV-2026-00482, la organización no quiere que el modelo proporcione interpretaciones diferentes en distintas ejecuciones del procesamiento.
Para estas tareas, una temperatura baja suele ser el punto de partida más adecuado.
| Temperatura | Comportamiento habitual | Escenarios documentales y de IA adecuados |
|---|---|---|
| 0–0.0 | Altamente determinista y enfocada | Extracción de campos, números de factura, fechas, importes, identificadores, clasificación documental y comprobaciones basadas en reglas |
| 0.1–0.3 | Principalmente coherente, con flexibilidad limitada | Identificación de cláusulas, reconocimiento de entidades, interpretación documental y análisis de cumplimiento |
| 0.3–0.5 | Mayor flexibilidad lingüística e interpretativa | Resúmenes de documentos, análisis de correspondencia y explicación de resultados |
| 0.5–0.7 | Mayor variación y formulaciones más amplias | Redacción de respuestas, generación de descripciones y elaboración de explicaciones alternativas |
| 0.7+ | Alta variabilidad y creatividad | Lluvia de ideas y generación de contenido creativo; por lo general, menos adecuado para la extracción estructurada de datos empresariales |
Estos rangos son orientativos, no universales. La escala de temperatura y su efecto varían según el modelo y el proveedor, y algunos modelos de razonamiento más recientes pueden limitar la temperatura o utilizar mecanismos de control diferentes.
Temperatura 0–0.0: captura de datos estructurados
Este rango resulta especialmente adecuado cuando se espera que la IA devuelva un valor específico que ya aparece en el documento.
Por ejemplo:
Extrae el número de factura exactamente como aparece en el documento. No incluyas etiquetas ni texto adicional.
Otros ejemplos son:
- números de factura y de órdenes de compra;
- fechas e importes;
- números fiscales y de registro;
- identificadores de clientes y proveedores;
- datos de cuentas bancarias;
- clasificación documental predefinida;
- resultados estructurados.
El objetivo no es la creatividad, sino producir la misma interpretación fiable de una misma información con la mayor consistencia posible.
Temperatura 0.1–0.3: interpretación controlada
Algunas tareas de procesamiento documental requieren interpretación en lugar de una simple extracción.
Por ejemplo, la IA puede tener que determinar si un contrato contiene una cláusula de renovación automática, identificar una cláusula de rescisión, clasificar un gasto o determinar si se cumplen determinados requisitos de cumplimiento.
En estos casos, una flexibilidad limitada puede resultar útil, ya que un mismo concepto puede expresarse de muchas formas diferentes.
Por ejemplo:
Determina si el acuerdo contiene una cláusula de renovación automática. Si está presente, identifica el periodo de renovación y el plazo de preaviso requerido para no renovarlo.
La respuesta debe seguir siendo controlada y estar basada en evidencias, pero la IA debe interpretar el lenguaje en lugar de limitarse a localizar un valor exacto.
Temperatura 0.3–0.5: resumen y análisis semántico
Una temperatura moderada puede ser adecuada cuando no se espera una única formulación exacta por parte del modelo.
Algunos ejemplos son:
- resumir contratos;
- explicar discrepancias entre documentos;
- interpretar comunicaciones de clientes;
- resumir reclamaciones de seguros;
- describir hallazgos de cumplimiento;
- explicar por qué un documento se derivó para su validación.
Por ejemplo:
Resume las principales obligaciones comerciales contenidas en este acuerdo en cinco puntos concisos.
Puede haber varias formas igualmente válidas de formular este tipo de resumen, por lo que cierta variación puede ser aceptable.
Temperatura 0.5 y superior: tareas generativas
Las temperaturas más altas adquieren mayor relevancia cuando el objetivo se aleja de la captura y validación de datos y se orienta hacia la generación de contenido.
Por ejemplo, la IA puede utilizar la información extraída de los documentos para redactar una respuesta a un cliente, preparar una explicación detallada, generar descripciones alternativas o crear una comunicación basada en los datos procesados.
En estos escenarios, una mayor variación puede resultar beneficiosa.
Sin embargo, en la extracción de datos documentales críticos para el negocio, las temperaturas más altas deben utilizarse, por lo general, con cautela, ya que la variación normalmente no es una característica deseable en la captura de datos.
La temperatura debe configurarse junto con el prompt
La temperatura no debe considerarse de forma aislada.
Una temperatura baja no puede compensar un prompt ambiguo.
Por ejemplo, preguntar:
Encuentra la fecha relevante.
resulta ambiguo independientemente de la temperatura.
Una instrucción mucho más precisa sería:
Extrae la fecha de emisión de la factura. No devuelvas la fecha de vencimiento del pago, la fecha de entrega, la fecha de la orden de compra ni la fecha de procesamiento del documento. Devuelve el valor en formato YYYY-MM-DD. Si la fecha de emisión de la factura no puede identificarse de forma fiable, no devuelvas ningún valor.
Combinar un AI Prompt preciso a nivel de campo con una temperatura adecuadamente baja proporciona al modelo unos límites mucho más claros para el resultado esperado.
El mismo principio se aplica a la clasificación, validación y análisis documental.
No existe una temperatura «óptima» universal
Puede resultar tentador buscar una temperatura óptima y aplicarla a todos los procesos de IA. En la práctica, la configuración adecuada depende de la tarea.
Por tanto, una organización puede utilizar distintas configuraciones dentro del mismo entorno de procesamiento documental:
Número de factura → Temperatura 0
Clasificación de facturas → Temperatura 0.1
Análisis de cláusulas contractuales → Temperatura 0.2
Resumen de contratos → Temperatura 0.4
Borrador de comunicación con el cliente → Temperatura 0.6
El principio fundamental es configurar el modelo en función de la naturaleza esperada de la respuesta.
Cuando debe existir una única respuesta precisa, es preferible una temperatura más baja. Cuando resultan útiles varias formulaciones o interpretaciones válidas, puede ser adecuada una temperatura más alta.
En el procesamiento documental basado en IA, esto significa que la captura de datos estructurados, la clasificación y la validación suelen operar en el extremo inferior del rango de temperatura, mientras que los escenarios de resumen y generación de contenido pueden admitir progresivamente una mayor flexibilidad.
En última instancia, la temperatura es otra capa de configuración que, junto con la selección del LLM, los Document Type Prompts, los Field-Level Prompts, las reglas de validación y los controles Human-in-the-Loop, ayuda a las organizaciones a adaptar el comportamiento de la IA a los requisitos de calidad de datos de cada escenario de procesamiento documental.
Configure la IA sin necesidad de ser un experto en IA
Mejorar el procesamiento documental basado en IA no debería requerir científicos de datos, ingenieros de prompts ni proyectos de IA prolongados.
Con elDoc, estas capacidades están diseñadas para que puedan configurarse directamente por los usuarios de negocio. Los usuarios que conocen sus documentos y procesos de negocio pueden indicar a la IA qué debe buscar, cómo debe interpretar la información, qué debe considerarse válido y qué debe hacer cuando la información está ausente o es ambigua.
Los tipos de documento, las instrucciones de clasificación mediante IA, los Field-Level AI Prompts, la selección del LLM, la temperatura, los campos obligatorios, la lógica de validación y los procesos Human-in-the-Loop pueden funcionar conjuntamente para mejorar de forma continua la calidad de los datos capturados de los documentos.
Además, las organizaciones no tienen que empezar desde cero. Como plataforma impulsada por GenAI, elDoc proporciona desde el primer día capacidades de comprensión documental y captura de datos listas para usar, sin necesidad de entrenar modelos tradicionales de extracción ni crear plantillas para cada diseño documental. La configuración adicional permite adaptar el comportamiento de la IA a los documentos, la terminología, las reglas de negocio y los requisitos de calidad de datos específicos de cada organización.
El principio es sencillo: no necesitas convertirte en un experto en IA para indicar a la IA qué necesita tu negocio.
Habla con un experto de elDoc para descubrir cómo elDoc puede aportar valor desde el primer día y, al mismo tiempo, ofrecer a tus equipos la flexibilidad necesaria para mejorar continuamente el reconocimiento documental, la captura de datos y la validación mediante IA.